Redis实现点赞、收藏、关注等原子计数 + 异步解耦设计
本文介绍了基于Redis实现高并发计数与异步解耦的设计方案。针对点赞、阅读量等高频操作,使用Redis的HINCRBY命令实现原子计数,避免并发问题。通过Spring的@EventListener和@Async实现业务解耦与异步处理,提升响应速度。同时采用Redis Pipeline减少网络开销,定时任务进行全量数据同步。方案还解决了事务一致性问题,使用游标分页处理大数据量,…
本文最初发布于 CSDN,现迁移至本站并做格式整理。内容保留原始观点与发布时间。
Redis 做计数器
在业务中,我们经常遇到“阅读量”、“点赞数”这种高频写、高频读的数据。如果直接操作 MySQL
1 | UPDATE article SET view_count = view_count + 1 WHERE id = 1001; |
在高并发下行锁竞争严重,性能慢。此时可以上Redis缓存在这种高频访问的数据上:
1 | public static Long hIncr(String key, String filed, Integer cnt) { |
这个方法对应的 Redis CLI 命令是: HINCRBY key field increment
- 原子性 (Atomicity): 这是该方法最大的价值。
- 在高并发场景下(例如 1000 个人同时点击一篇文章),如果我们在 Java 代码中写
get->value + 1->set,会出现并发安全问题(数据丢失)。 - Redis 的
HINCRBY是单线程原子执行的,它保证了无论多少人同时调用,由于 Redis 是单线程处理命令,计数值绝对准确,不需要在 Java 层加锁(如synchronized)。
- 在高并发场景下(例如 1000 个人同时点击一篇文章),如果我们在 Java 代码中写
- 容错性:
- 如果
key不存在,Redis 会自动创建。 - 如果
field不存在,Redis 会将其视为 0,然后执行加法。
- 如果
为什么不用
redisTemplate.opsForHash().increment(...)?
虽然 opsForHash() 更简单,但该代码使用了 execute(RedisCallback) 模式,这是一种更底层的写法:
- 控制粒度: 直接操作
byte[],避免了RedisTemplate默认序列化器可能带来的一些额外开销或格式不兼容问题。 - 性能: 在极高性能要求的场景下,直接操作 Connection 稍微快一点点(但也增加了代码复杂度,需要手动处理字节转换)。
解耦与消息机制
比如在实际设计场景中,点赞之后,除了计数器更新之外,还有用户活跃度更新,如果所有的逻辑都放在业务中,会导致业务的耦合较重
1 |
|
A. @EventListener(classes = NotifyMsgEvent.class)
- 作用:这是 Spring 提供的观察者模式实现。它声明该方法是一个“监听器”,专门监听
NotifyMsgEvent类型的事件。 - 原理:当业务代码调用
applicationContext.publishEvent(new NotifyMsgEvent(...))时,Spring 会自动找到这个方法并执行它,进而触发计数。
B. @Async
- 作用:异步解耦执行。
如果没有@Async,虽然代码逻辑上解耦了,但实际上还是在同一个线程里顺序执行的。用户点赞后,必须等 Redis 更新完才能看到响应。
加上@Async后,Spring 会将这个方法的执行扔给一个独立的线程池。 - 效果:主线程(处理用户请求的线程)发布完事件立刻返回成功给用户,用户体验快;而 Redis 的更新操作在后台线程慢慢跑,这里积分更新等操作也可以扔给Event或MQ慢慢跑。
C. 事务一致性问题 (Transaction)
- 隐患:如果在
praiseRepository.save()事务提交之前发布了事件,而在这个@Async方法里读取数据库,可能会读不到数据(因为主事务还没提交)。或者, 主事务回滚了,但事件已经发出去并把 Redis 里的数字加了 1,导致数据不一致。 - 解法:使用
@TransactionalEventListener。
它可以配置为phase = TransactionPhase.AFTER_COMMIT。只有当数据库事务成功提交后,才触发这个监听器。这保证了业务数据的强一致性。
Redis Pipeline、定时任务全量更新
1 | RedisClient.pipelineAction() |
- 场景:用户阅读一篇文章,需要同时更新两个计数器:
- 文章本身的阅读数 +1
- 文章作者的总被阅读数 +1
- 知识点:
- 如果不使用 Pipeline,客户端需要发两次请求给 Redis,经历两次 RTT(往返网络延迟)。
- Pipeline 允许客户端把一组命令一次性打包发给 Redis,Redis 执行完后把结果一次性返回。这极大地减少了网络开销,提升了吞吐量。
1 |
|
知识点 - 游标分页 (Cursor-based Pagination):
- 这里使用了
where id > lastId limit 20的方式进行滚动扫描。 - 这是处理全量数据的标准范式:少量多次,既不一次读出撑爆内存,也不长期占用数据库连接。
本博客所有文章除特别声明外,均采用 CC BY-NC-SA 4.0 许可协议。转载请注明来源 王越峰!
相关推荐
2025-10-11
【Spring事务失效的常见原因】同类内部调用导致 @Transactional 不生效
Spring中@Transactional事务失效的常见原因是同类内部方法调用导致AOP代理失效。事务基于动态代理实现,若通过this.方法()直接调用,会绕过代理对象,使事务注解失效。解决方案是通过AopContext.currentProxy()获取代理实例调用方法,并配置@EnableAspectJAutoProxy(exposeProxy&#x...
2025-11-26
全局异常处理的两种策略:HandlerExceptionResolver和RestControllerAdvice
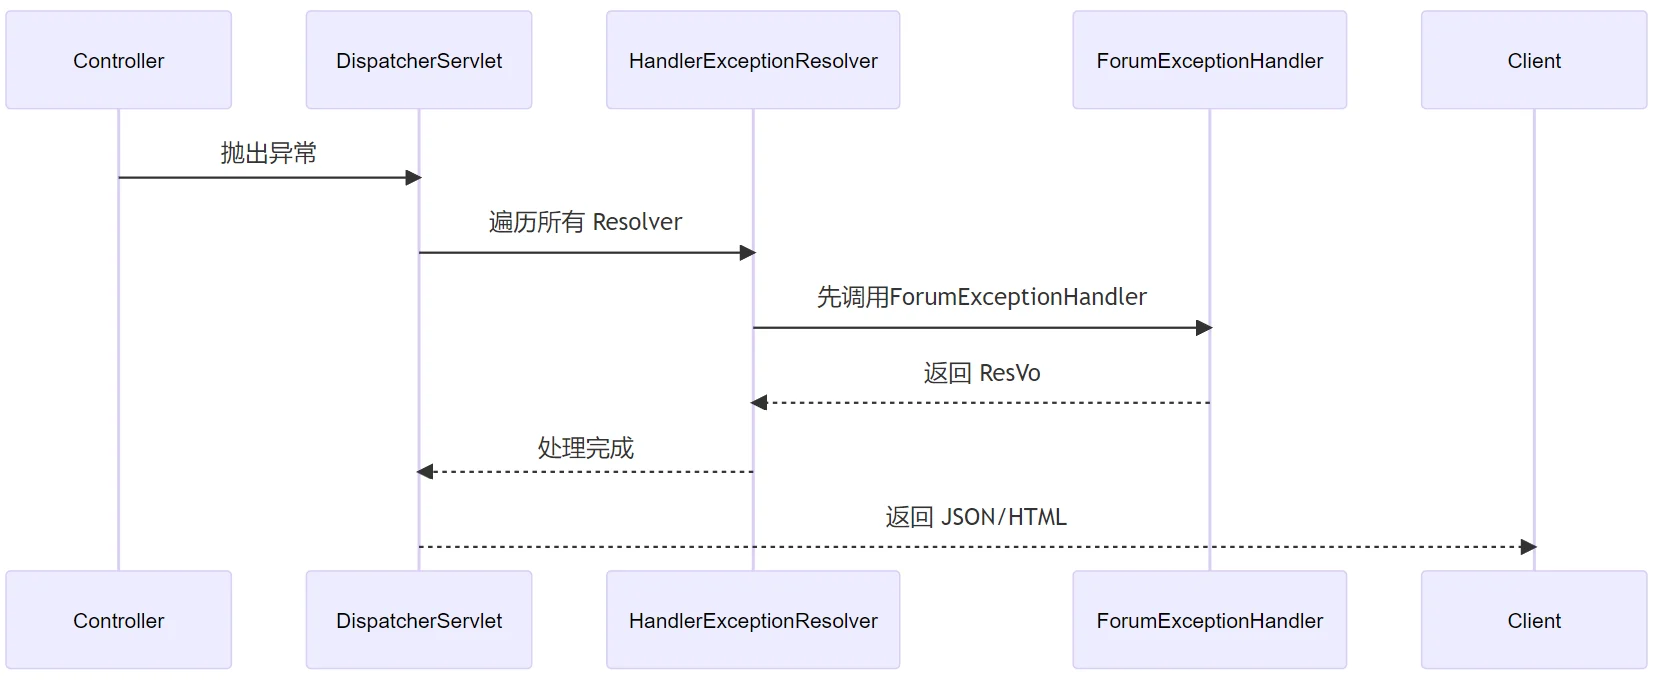
本文对比了Spring中两种全局异常处理策略:HandlerExceptionResolver和@RestControllerAdvice。HandlerExceptionResolver是Spring底层的异常解析机制,需要手动注册到处理器链中,优先级高且处理范围广,适合框架级异常处理;而@RestControllerAdvice基于注解实现,使用简...
2025-12-30
静态工具类封装和Spring Bean依赖注入两种模式的区别
本文对比了静态工具类封装与Spring Bean依赖注入两种模式的实现与使用差异。静态工具类通过手动初始化将Spring管理的Bean注入到静态变量中,使用时直接调用类方法,适合纯粹的功能性操作;而Spring Bean模式由容器托管生命周期,支持依赖注入和AOP等特性,适合包含业务逻辑的组件。实际开发中应根据场景选择:工具类操作使用静态封装提升简洁性...
2026-01-23
使用Spring AMQP优化技术派RabbitMQ部分
本文介绍了使用Spring AMQP优化技术派RabbitMQ的实现方案。原方案采用连接池方式存在长连接问题和单线程处理瓶颈,优化后通过Spring AMQP内置的CachingConnectionFactory管理连接池和Channel缓存。主要改进包括:使用@RabbitListener实现消费监听、配置生产者确认和失败回调机制、引入Redis分布...
2025-11-26
理解分层架构:彻底理清 VO、DTO、BO、PO、DO 的边界与流转
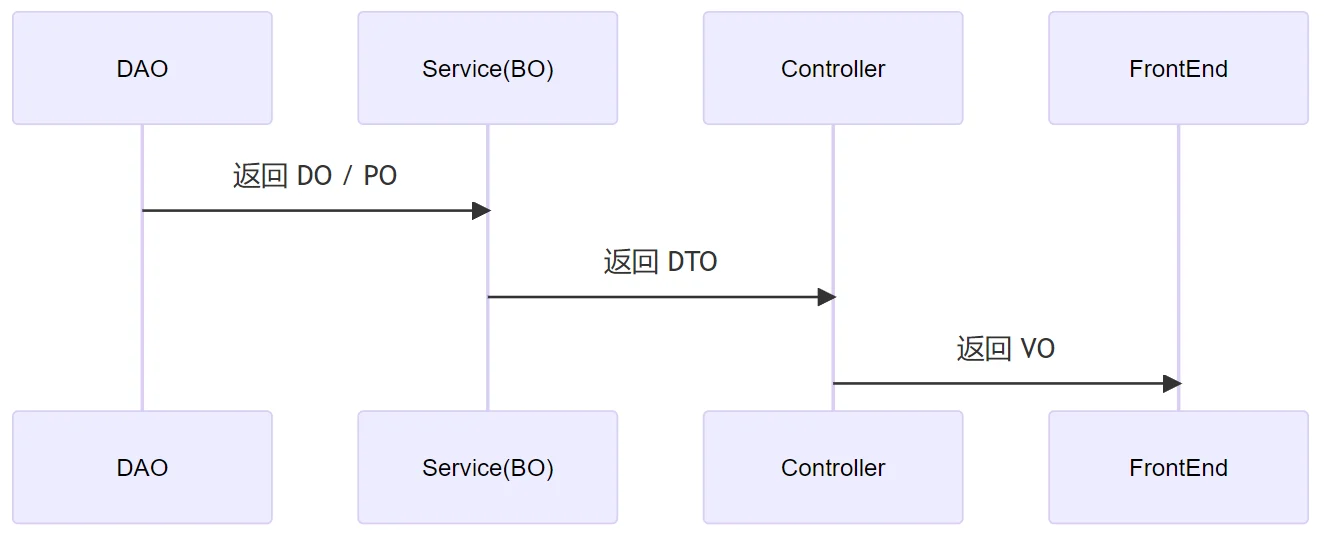
本文介绍了分层架构中常见的VO、DTO、BO、PO、DO等数据对象的概念及流转过程。这些对象分别承担表示层、业务层和数据层的特定职责,确保系统各层之间的隔离和安全性。DO对应数据库记录,BO封装业务逻辑,DTO用于跨层传输,VO是前端视图对象。文章通过传统三层架构和DDD架构的对比,展示了这些对象在不同架构中的流转路径。POJO作为基础Java类,是这...
2025-10-11
【秒杀中的并发】如何避免全局单线程和实现细粒度锁
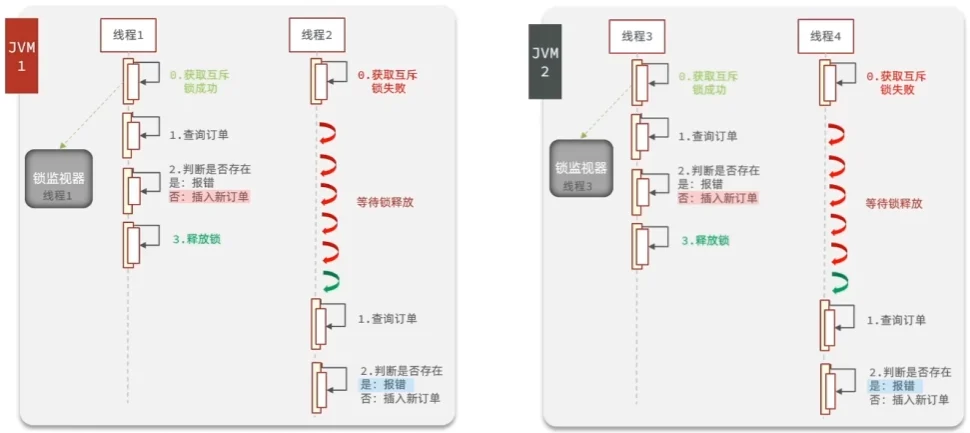
黑马点评项目实现”秒杀优惠券一人一单”功能时,通过优化锁机制提升并发性能。关键点在于使用synchronized(userId.toString().intern())替代方法级锁,确保相同用户请求串行执行(防止重复下单)而不同用户请求并发执行。采用字符串常量池机制保证相同用户ID对应同一锁对象,解决了直接使用Long类型时因对象引用不同导致的锁失效问...